AI 写了 90% 的代码,Claude Code 团队怎么做 code review
作为 AI coding 的重度用户,我最常被问到的一个问题是:AI 会幻觉、会犯错,你怎么敢信它写的代码?
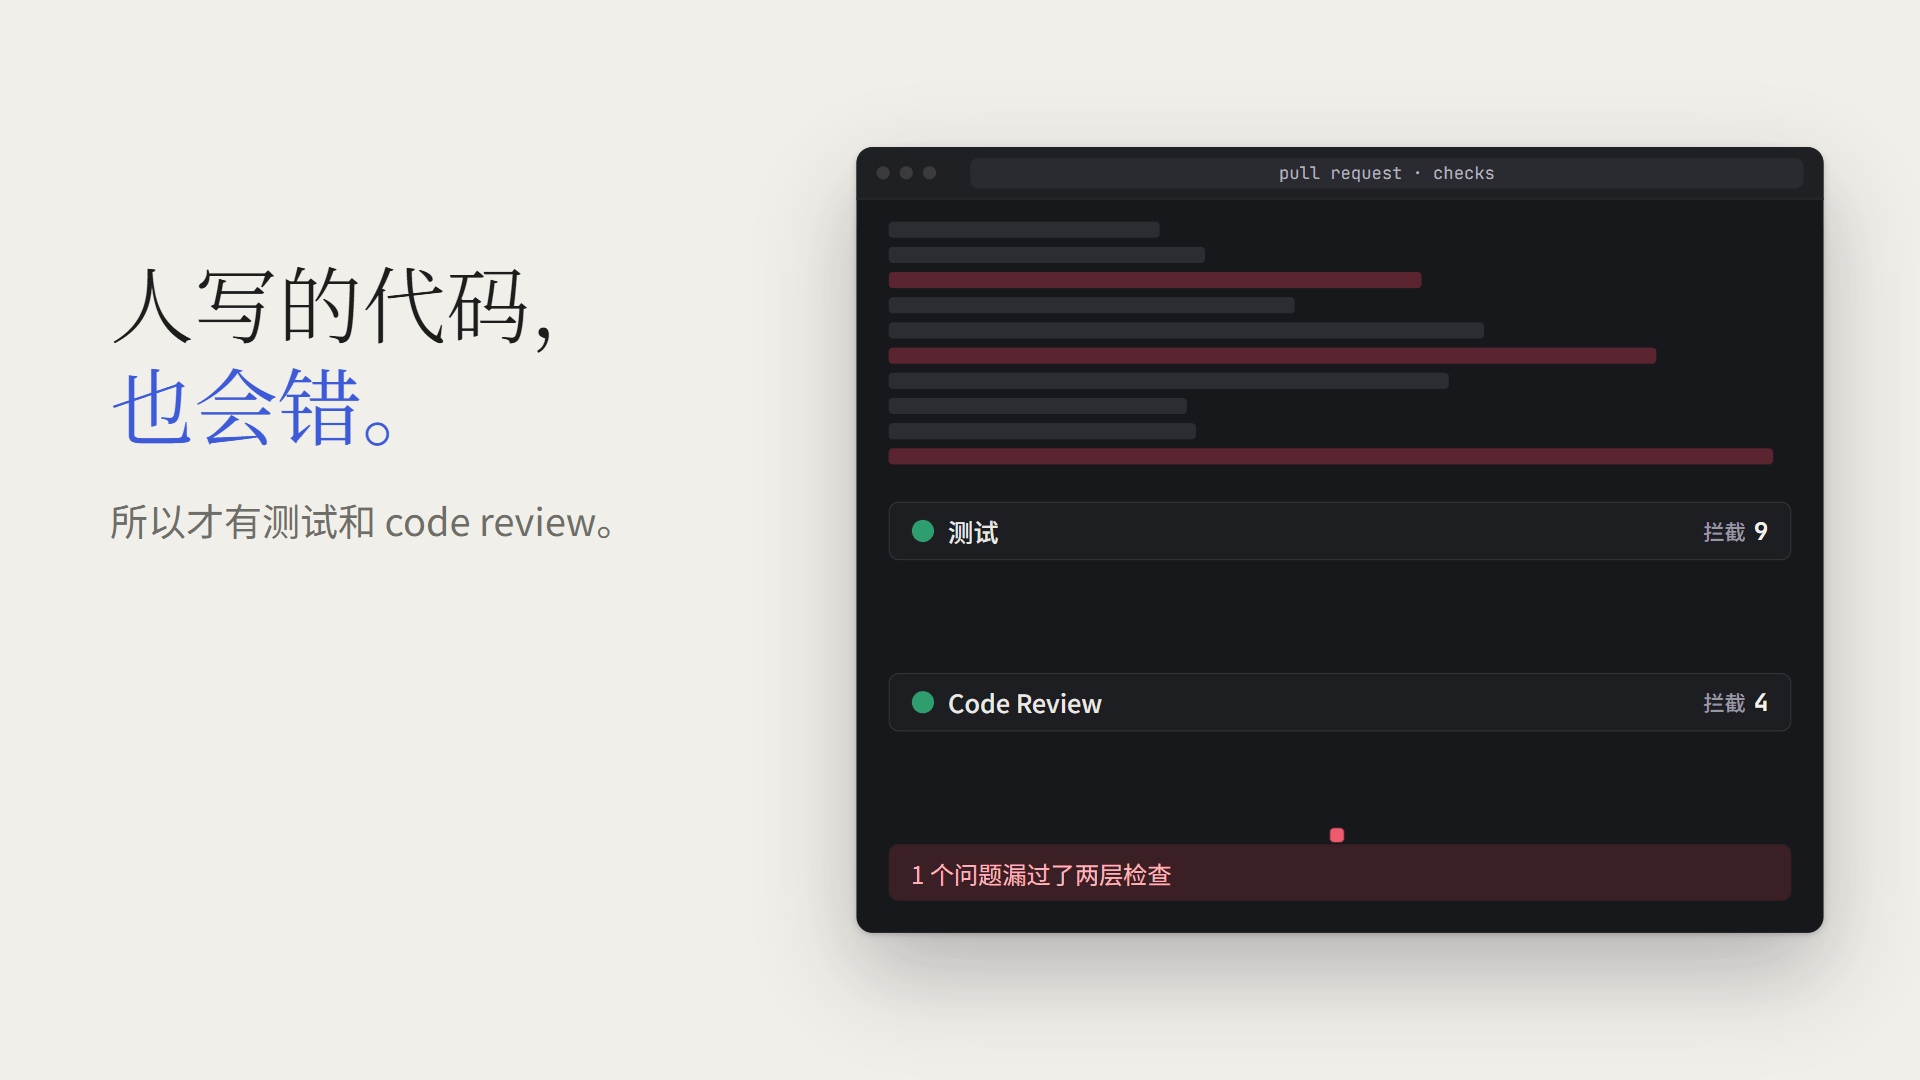
我的回答一直是:你本来就不该指望它不出错,人写代码也做不到。在手搓代码的年代,我们靠 code review 和测试用例拦住失误;到了 AI 写代码的年代,这套逻辑其实没变,变的是”拦”的方式。
在 Floeva(我们在做的 AI 智能可穿戴项目)中,我自己的时间分配也很能说明这一点:花在前期需求讨论、搭建 code review 和测试流程上的时间,比写具体功能代码的时间多得多。
前几天 Claude Code 团队发了一篇文章《How the Claude Code team does code review》,讲在 Claude 写了约 90% 代码的情况下,他们怎么做 review。读完我的第一感受是,这和我们在摸索的流程很像,而且它把几个我们也反复纠结的问题讲得更系统:哪些修改还要人看?AI 审 AI 会不会没完?审查的 AI 漏了怎么办?人不读代码怎么懂代码?出了事算谁的?
这篇就按这五个问题,把原文里我觉得最值得借鉴的部分整理出来。
先换一个问题:不问”有没有人读过”
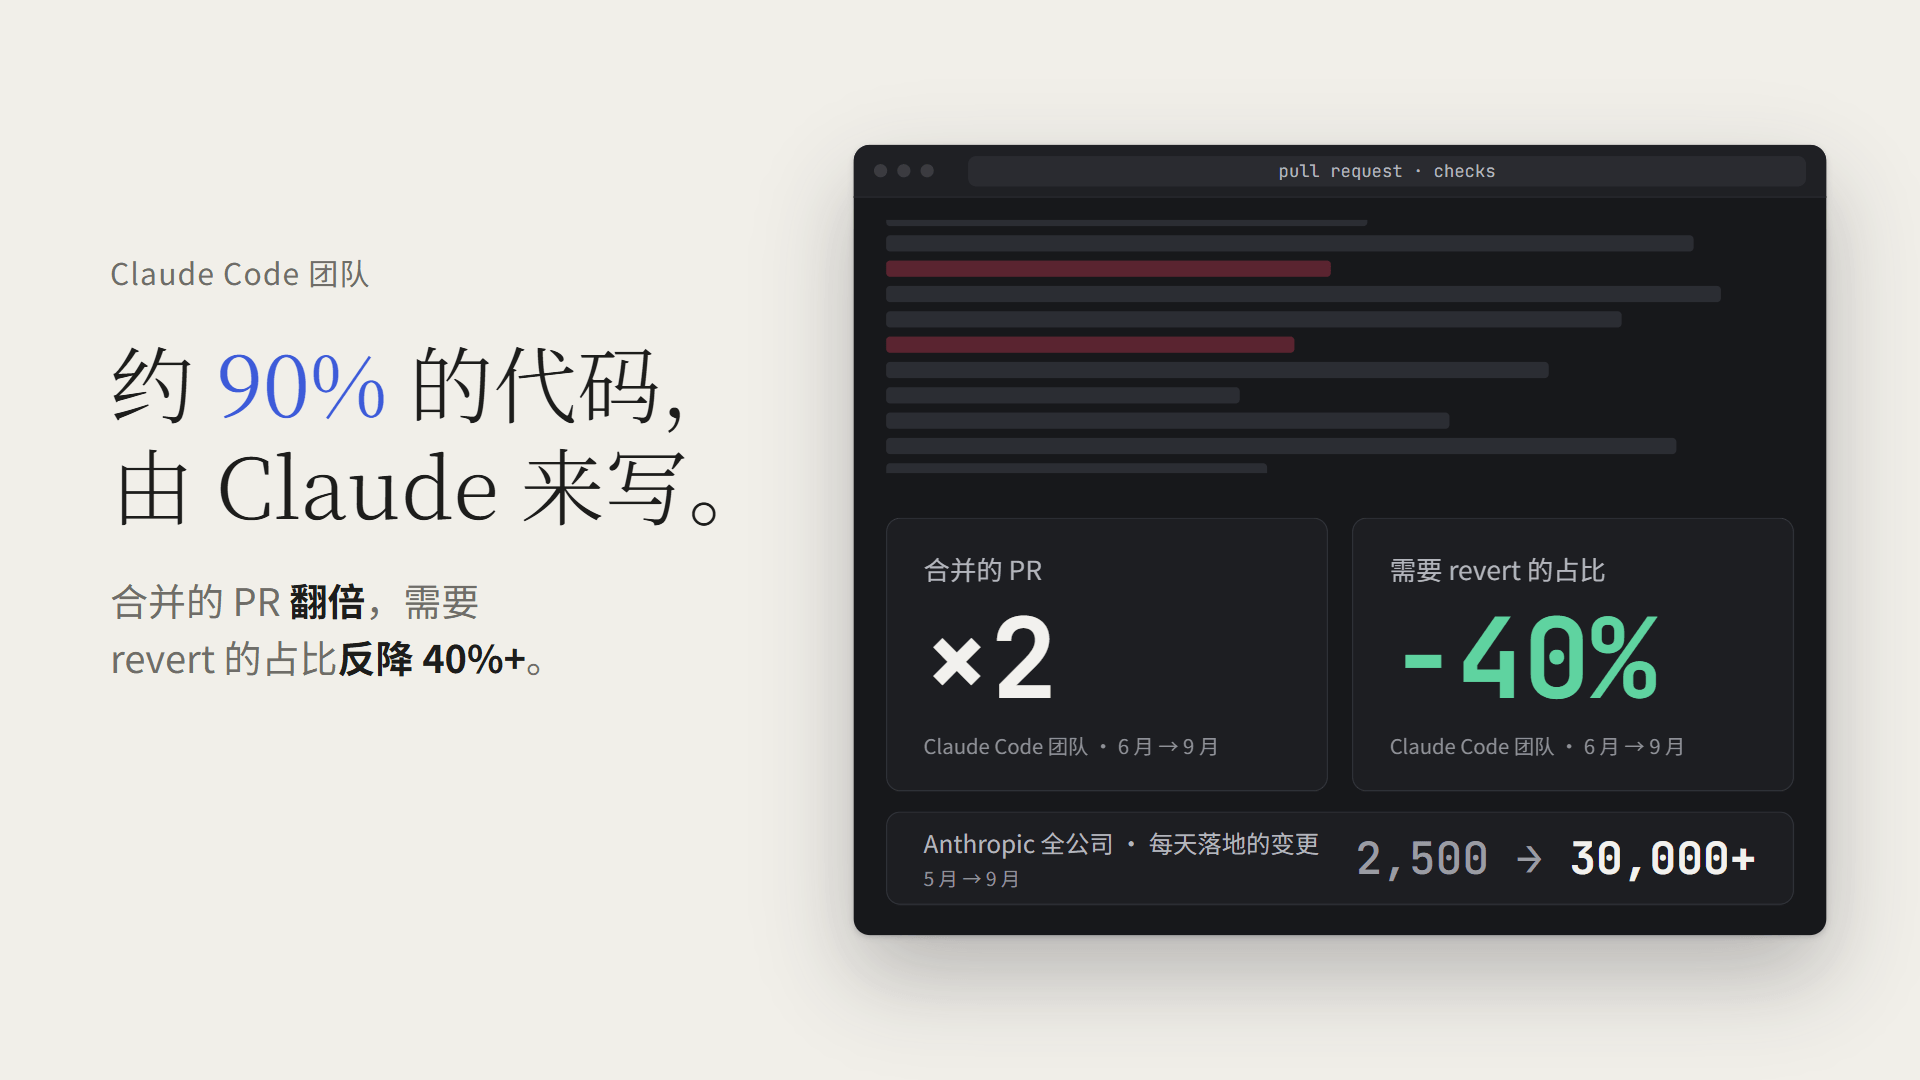
从 6 月到 9 月,Claude Code 代码库合并的 PR 数量翻了一倍多,需要回滚的比例反而下降了 40% 以上。
放大到整个 Anthropic 公司视角来看的话,压力更明显:Anthropic 主代码库每天落地的变更,从 5 月的约 2,500 个涨到了 9 月的 3 万多个。这个量级增长下,逐行人工 review 已经不现实。
原文的做法是先换问题。”有没有人读过这段代码”只是一个不太精确的替代指标,真正要问的是:这个改动可能怎么出错,哪一道检查(自动的或人工的)最适合拦住它?
问题一换,review 发生的时间也变了。过去 review 是路尽头的一道关卡:写完代码、开 PR、等同事看。现在 review 更像写作时的拼写检查,一直在跑,大部分改动在人被叫来之前,已经被 Claude review 并修过至少一轮。
他们把稀缺资源定义得很清楚:人的时间和注意力。这个”时间”包括两头,一头是人花在 review 上的时间,另一头是人花在修坏代码上的时间。只减前者、让后者涨回来,等于没省。所以目标是大部分 PR 最多只需要一个人参与(可以就是作者本人),同时回滚和事故率不上升。可以将回滚和事故率看成是护栏,一旦上升,说明时间只是被挪到了别处。
一个改动要过七层
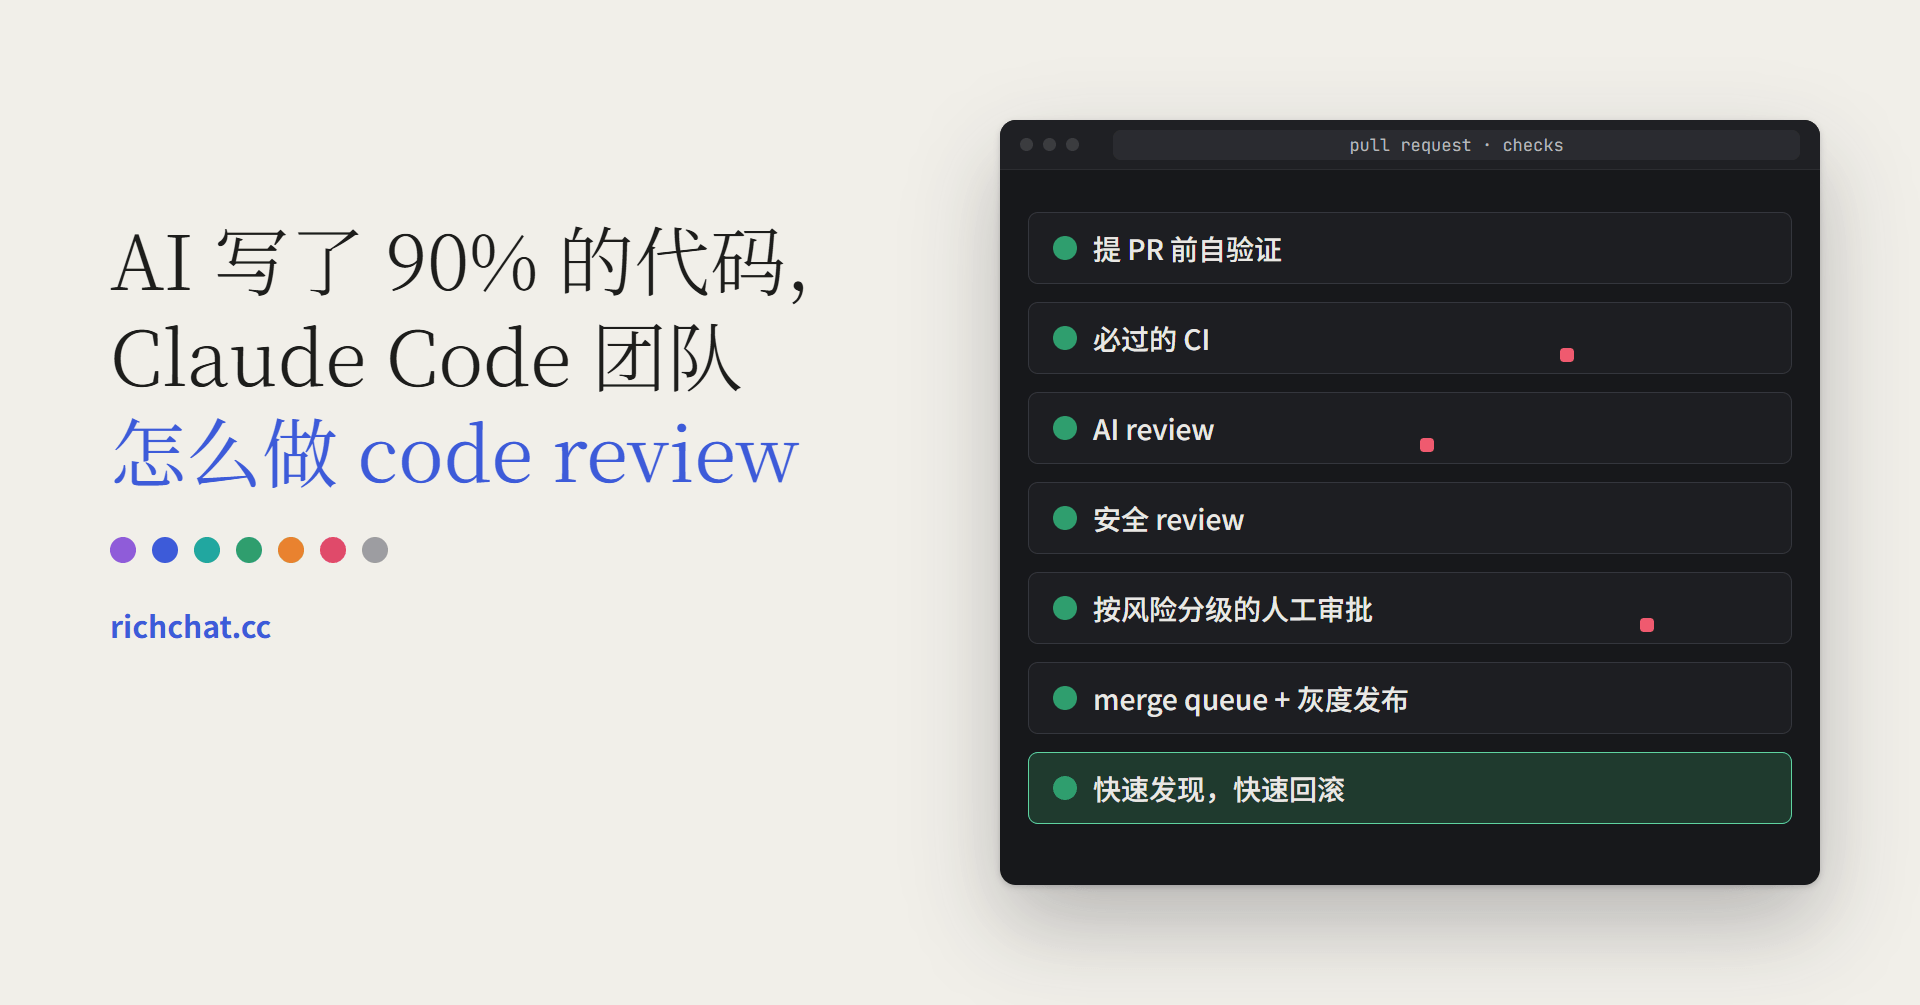
原文把一个改动从作者电脑到用户手里的过程,拆成了七层:
- 提 PR 前自验证:让 Claude 跑测试、构建、lint,拿出运行结果,而不是一句”做完了”;再让一个新上下文的子 agent review 这份 diff
- 必过的 CI:lint、类型检查、多平台测试、构建,红了就不能合
- AI review:多个 agent 并行找 bug,另一组 agent 对每条发现投票,足够多票认为是真问题才会贴出来
- 安全 review:单独一轮,任何一条没关闭的发现都会阻止合并
- 按风险分级的人工审批:由分类器判断要 0 人、1 人还是 2 人
- merge queue、flag 和灰度:在最新的 main 上重跑检查;新功能先放在 flag 后面给 Anthropic 员工用,再逐步放给用户
- 快速发现、快速回滚:flag 不用发版就能关,团队有每周轮值的 on-call,事故复盘会问”本该由哪一层拦住”
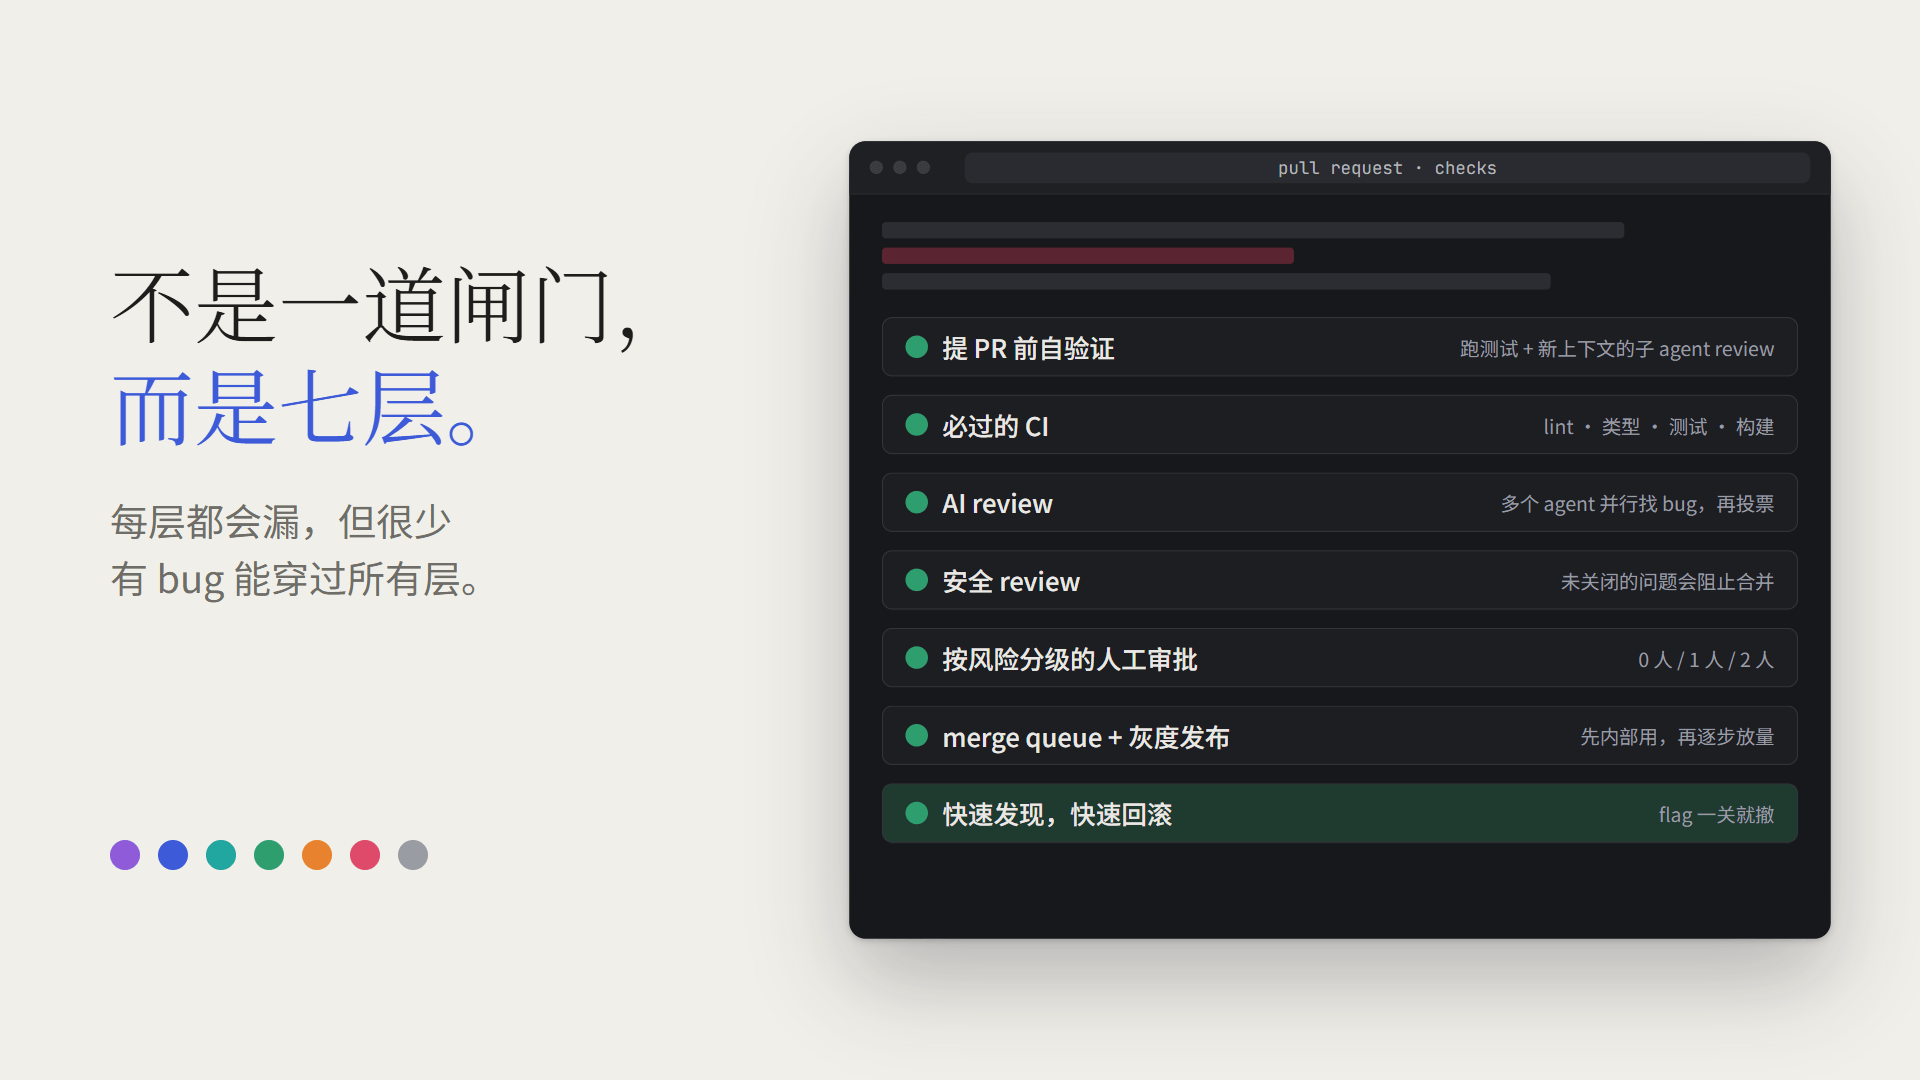
原文配图的图注里有一句话,我觉得非常点题:
Each layer catches some problems and misses others. Few get through all of them, and rollback handles the rest.
每一层都会拦住一些问题、漏掉另一些,很少有问题能穿过所有层,剩下的交给回滚。这其实就是对开头那个问题最直接的回答:不需要任何一层完美,包括 AI,也包括人。
有个细节我很喜欢。当自动 reviewer 反复提同一类问题时,他们去源头修:写进 skill、加一条 lint 规则,或者更新 CLAUDE.md 和 REVIEW.md。REVIEW.md 由 code owner 来写,告诉 reviewer 这块代码里什么最要紧。好的 REVIEW.md 都很短,会写清楚在这个仓库里”出错”长什么样,比如文档出错是”它在撒谎”,配置出错是”它把流量导错了”。
五个问题,官方怎么答
哪些修改还要人看?
风险由改动决定,不由作者决定。 分类器读改动内容来定档:
| 风险 | 例子 | 需要几个人批准 |
|---|---|---|
| 低 | 文档、文案、内部功能、放在 flag 后面的新增改动 | 自动 review 和安全检查通过后,不需要人 |
| 中 | 普通产品改动,以及缓存、自动更新器、system prompt 这类敏感区域 | 1 人 |
| 高 | 最高风险的代码,以及一小批永远要两个人的路径 | 2 人 |
另一个分类器还会单独判断:这个改动档位虽低,是否仍然需要人看。owner 标为敏感的路径和所有 CI workflow 文件,永远要人。
几条配套规则同样关键。只有仓库信任名单上的作者(主要是负责这块的团队)能走轻量通道;agent 的批准永远不算人的批准;一次批准只对应一个具体的 commit,之后如果有系统无法担保的新提交(比如 agent 又推了一次),就要重新批准。
AI 审 AI,会不会没完没了?
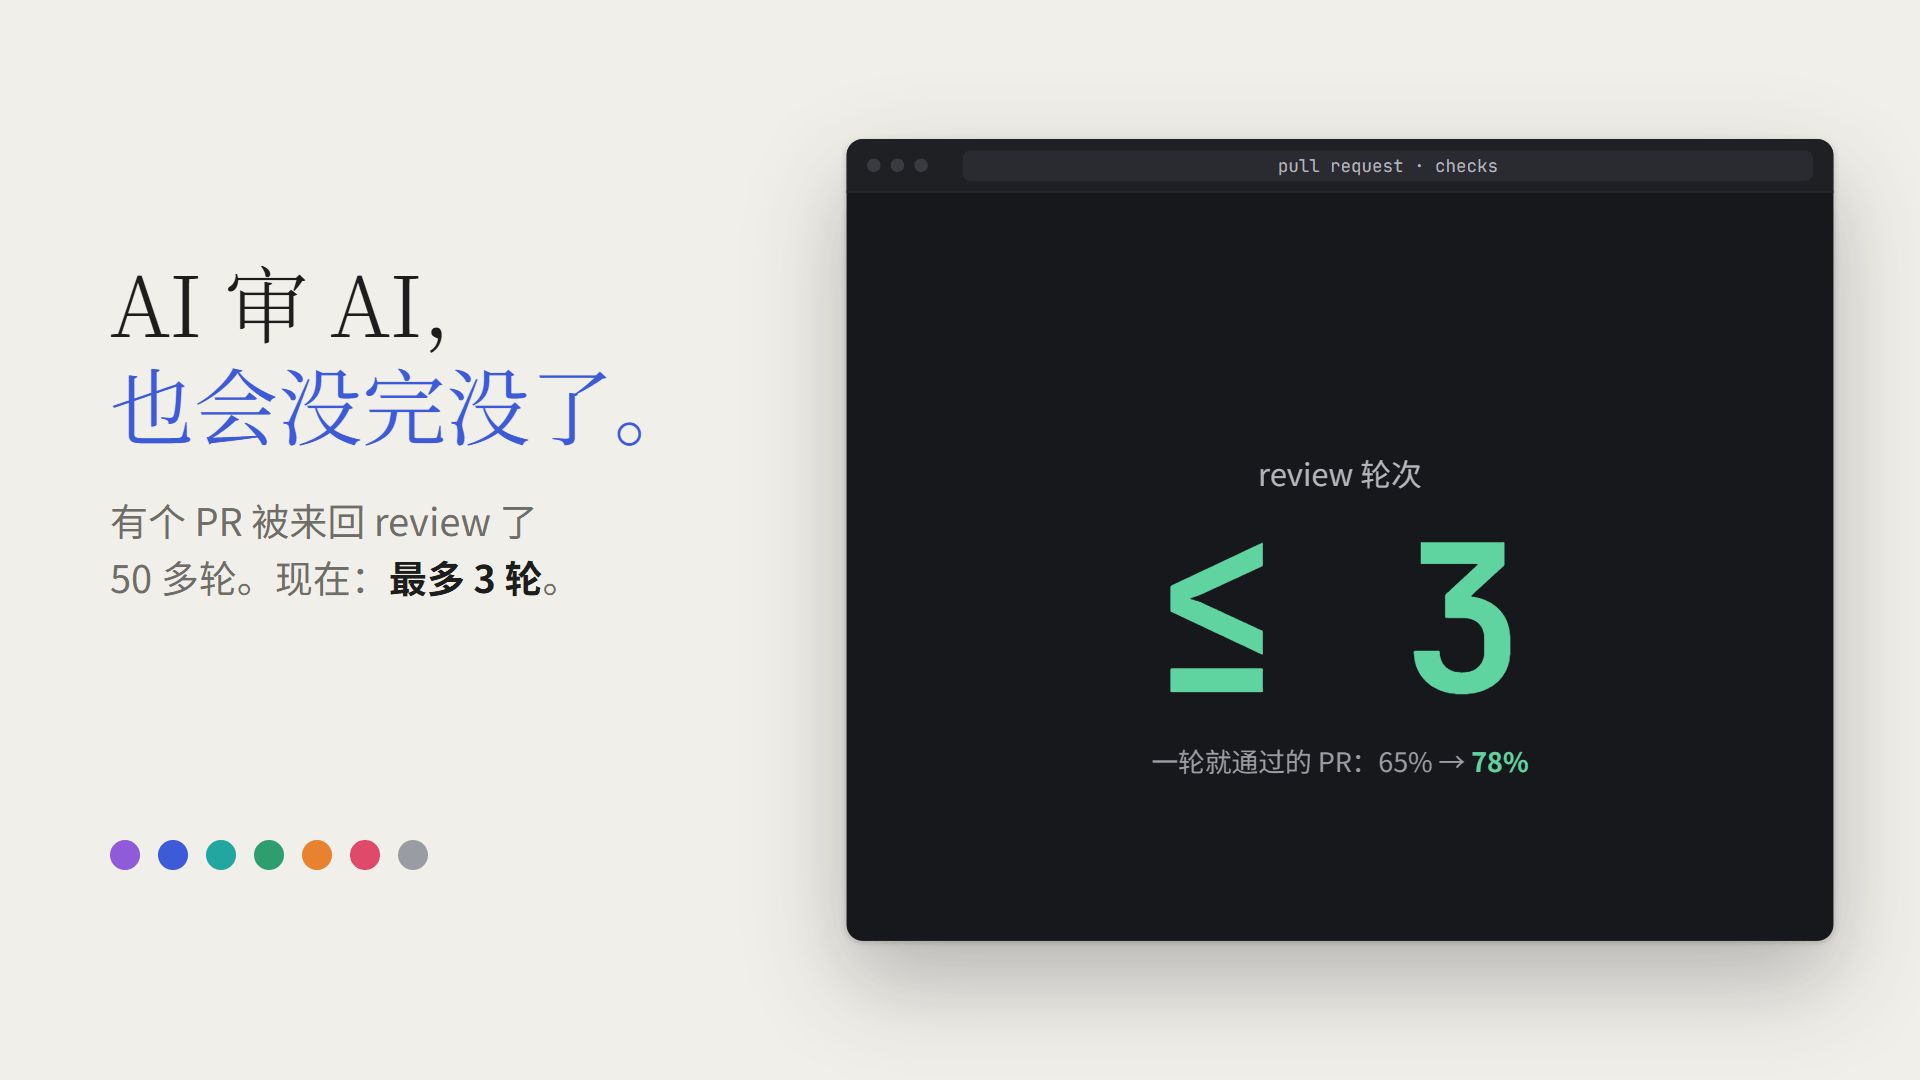
会。原文讲了一个很真实的例子:有个 CLI 的 PR 在一夜之间被 review 和修复了 50 多轮,直到作者手动叫停。
他们对 reviewer 反复提出的问题做了 git blame,发现约 59% 指向的是 reviewer 第一轮时就已经存在的代码。也就是说,reviewer 很少在发现新 bug,只是每一轮多挖出几个老问题。原文也坦白是自己把情况搞糟的:大家习惯了默认跑好几轮,因为每一轮总能多找到点东西。
改法有四条:最多 3 轮,超过就请作者退一步重新想方案;前几轮之后只 review 新的 diff;指出”一类 bug”,让作者一次改掉所有同类问题;已经提过的问题不再重复提。
效果很明显。一轮就通过的内部 PR 从 65% 升到 78%,需要 5 轮以上的从 8.9% 降到 1.5%,平均 review 次数从 2.08 降到 1.32。
这一节里还有一句我觉得很有洞察:作者是 agent 的时候,噪声的代价更高。人看到一个无关紧要的 nit,几秒钟就跳过了;agent 会认真去修,于是多一次提交,再多一轮 review。
审查的 AI 漏了怎么办?
把事故变成评测集:团队收集了过去导致事故的 PR,连同后续的修复和 revert,请熟悉那块代码的工程师确认每个 bug 和它的位置,reviewer 每天对这个集合跑一遍。每改一次 reviewer 的 prompt、工具或模型,都对全部用例打分,分数上去才保留。
他们同时也测噪声。每条 review 意见按 PR 作者的反应归类:修了、说它错了、说这是有意为之,还是觉得不重要。他们还会拿已知干净的 PR 去跑 reviewer,统计它有多少次会诱导人做出有害的修改。写下来的优先级是:先抓真 bug,其次才是减少 review 轮次。
人不读代码,怎么懂代码?
code review 一直还有第二个作用:让团队了解代码库。如果机器读了大部分代码,人还怎么学?
原文的回答很坦诚:没有正式流程。团队里没有人脑子里装着 Claude Code 的完整模型,他们也不认为有人需要。想了解哪一块,就让 Claude 针对那一块写一份讲解,几分钟就好,而且反映的是代码此刻的样子。有人会更进一步,让 Claude 做一个小的可视化 artifact,按自己习惯的方式来讲这块代码。
这一点我们在 Floeva 项目中也很有共鸣。我们现在大量用可视化的 HTML 页面帮团队理解具体实现,比直接读代码或 spec 文档容易得多。原文有句话说得很到位:一行文案改动,逐行读它几乎学不到东西;给你马上要改的模块写一份讲解,能学到很多。
出了事,算谁的?
“You land it, you own it”,你合进去的,你负责。在 agent 写的 PR 上,指挥 agent 的那个人算作一个必需的 reviewer,就像这段代码是他亲手敲的一样。
这条规则能成立,靠的是几个前提:改动小,所以好 review、好调试、好回滚;一切可撤回,flag、revert 和分阶段发布能在几分钟内撤掉大部分错误;影响范围决定门槛,越贵的代码要越多的人和检查;通过遥测和内部使用能很快发现回归。还有一点很重要,它不是追责。让你来修,是因为你手里的上下文最多;事故复盘看的是系统。
人最后只做五件事
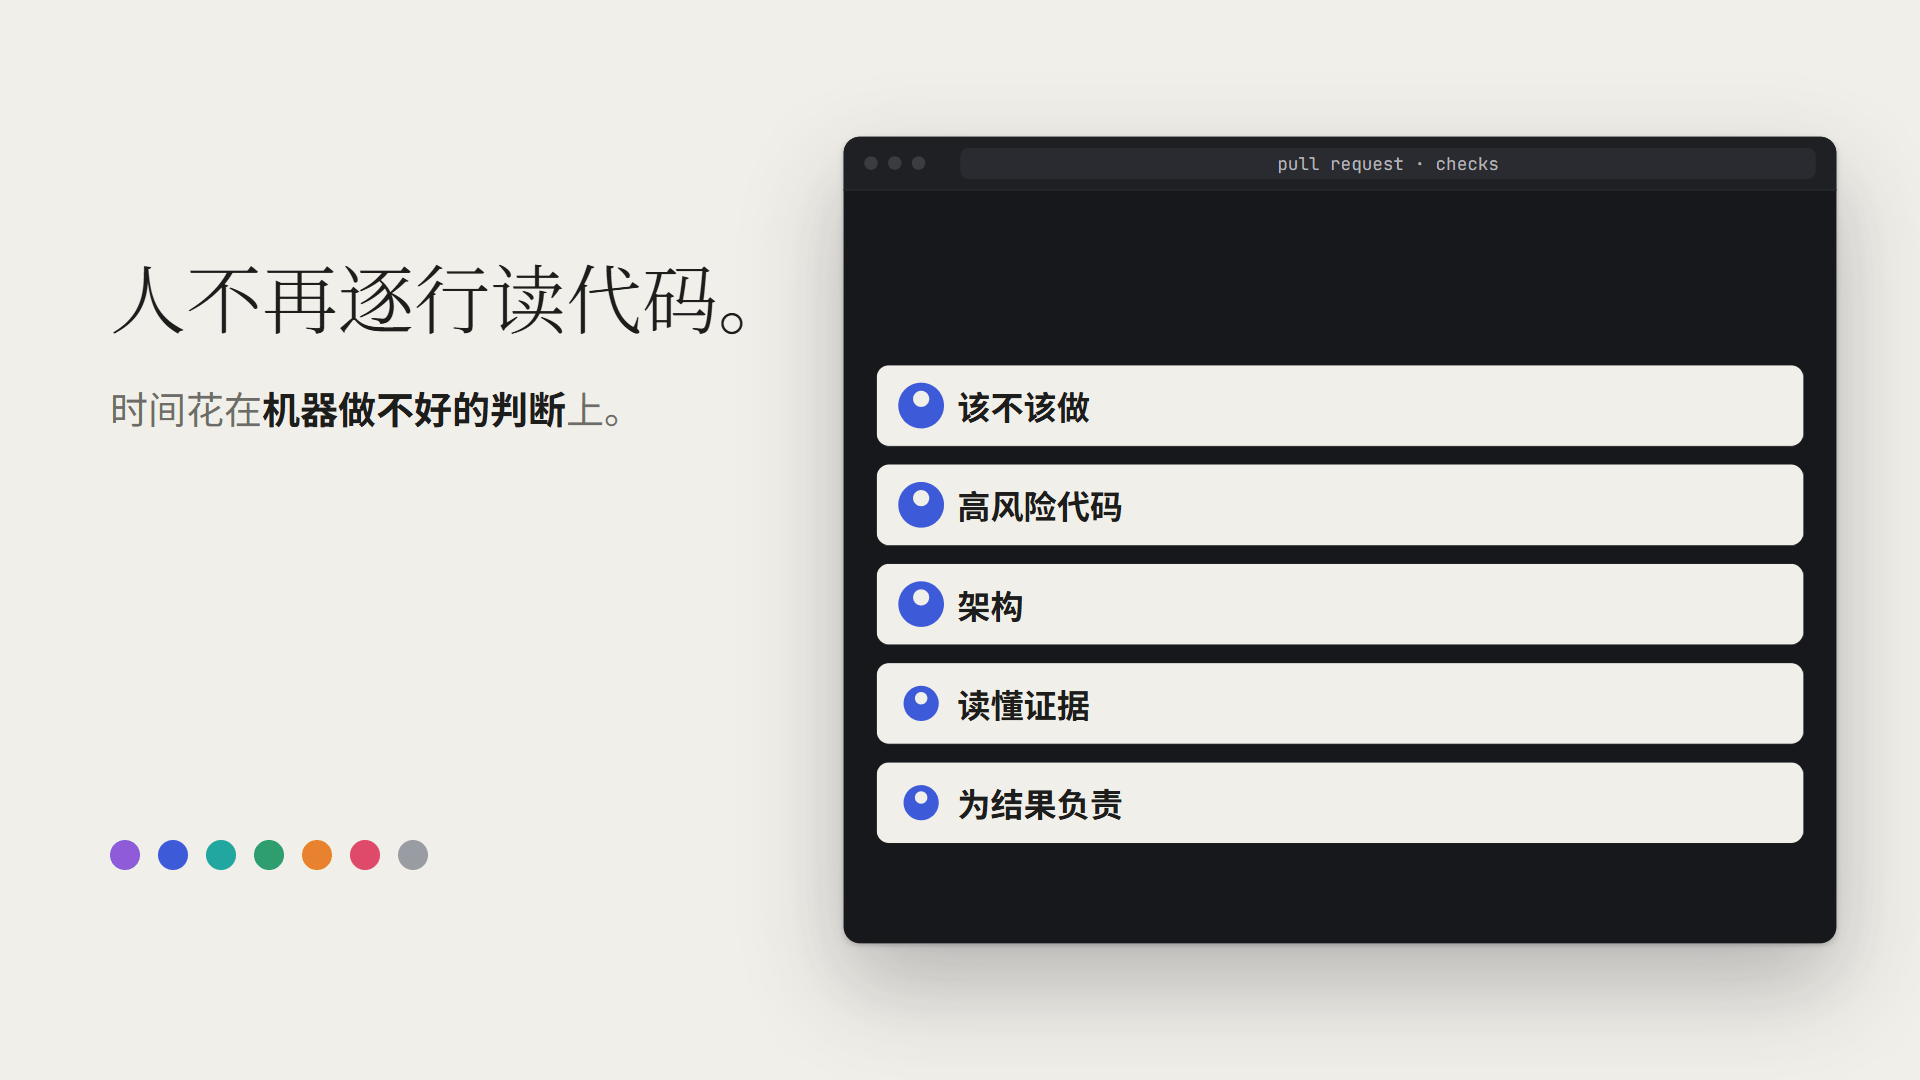
原文专门讲了人在这个流程中的应该做什么 - 把资深工程师从深度工作里拉出来查一个常规错误,成本远高于一次自动 review。所以人的工作,从读每一个 diff 转到了机器不擅长的判断上:
- 该不该做:方向、品味和范围
- 高风险代码:计费、自动更新器、CI workflow
- 会被别人照着抄的架构
- 读懂证据:测试输出、跑了什么命令、返回了什么、截图、reviewer 的发现;说不清这些检查会漏掉什么,就该要求一次真正的 review
- 为结果负责:每个上线的改动都有一个人负责,不管代码是谁敲的
回到开头那个问题:”AI 会犯错,怎么信它写的代码?”
我们从来没有靠”写代码的人不犯错”来保证质量,过去不是,现在也不是。质量来自一层层的检查、能快速撤回的发布,以及把人的注意力放在真正需要判断的地方。人不再逐行读代码,时间花在机器做不好的判断上。这也是为什么在 Floeva,我花在需求讨论和搭建这套流程上的时间越来越多。
原文末尾有一份”怎么在你的团队落地”的清单,我精简后附在这里,按代码改动的生命周期分四组:
- 提 PR 前:给 agent 能跑的检查,写进简短的
CLAUDE.md,再用 hooks 跑格式化和 lint;本地跑/code-review、/security-review,或者用新上下文的子 agent review;加一个REVIEW.md,把反复出现的 review 意见沉淀进去 - 每个 PR:必过的 CI,PR 模板加上”测试””风险””怎么回滚”;先在一个仓库接入 AI reviewer,调几周
REVIEW.md再推广;加自动安全 review,所有 review 线程关闭才能合并;review 力度匹配风险;限制 review 轮次,几轮之后只看新 diff - 审批:写下风险分级,按改动定档,先严后松;轻量通道只留给信任的作者;用 CODEOWNERS 和分支保护,让鉴权、计费、CI 与发布流程、安装器永远需要人;机器人的批准不能代替必需的人工批准,有新提交就作废旧批准
- 合并之后:merge queue、feature flag、内部先用、分阶段发布、一键回滚;把事故和 revert 变成评测集,reviewer 的 prompt、工具或模型一变就重新打分;度量人的时间,用 revert 和事故率当护栏
原文:How the Claude Code team does code review(Addy Osmani、Morgan Westlee Lunt、Qing Wang,claude.dev Blog,2026-10-15)