新模型来了,你的公司变好还是变差?旧金山 48 小时的 40 条观察
如果下个月出了一个更强的新模型,你的公司会变好,还是变差?
这是 Greg Isenberg 在旧金山一场饭局上听到的问题。他说问题一出口,半桌人都没接话。他这 48 小时见的是亿万富翁、数据公司,还有一批规模在 10 亿到 1000 亿美元之间的 AI 公司的创始人和高管。
在启动现在这个 AI 智能穿戴项目之前,我也用这个问题挑战过自己。它让我想起互联网创业的黄金年代,VC 特别爱问的一句是:”如果腾讯也要做,你怎么办?”到了 AI 时代,投资人和创业者也许都可以把这句换成:”如果下个月出了一个更强的新模型,你的项目会更好还是更差?”
Greg 是连续创业者,也是播客 The Startup Ideas Podcast 的主持人。他回来在 X 上连发两条长帖,一共 40 来条观察。这个饭桌问题是我读下来最值钱的一条,因为它还能当筛子用:把剩下的观察倒进去,大部分会自己分成两堆。
一个让半桌人沉默的问题
这条在评论区被引用得最多,很多人说它是眼下判断一家 AI 公司最锐利的问题。
它锐利,是因为它能把两类公司分开。一类公司在”租”模型的优势:产品好用,是因为它比别人早半步用上了更强的模型,或者在模型的短板上打了个补丁。下一代模型一来,这半步被追平,补丁也不需要了。另一类公司正好相反,模型越强它越好用,因为它卖的东西,模型自己给不了。
“腾讯也做怎么办”问的是巨头会不会进场;这个问题问的是,你的护城河是不是随时会被下一次模型更新填平。巨头进场至少要几个月,模型更新可能就在下周。
下面按这把筛子,把 Greg 两条帖子里我觉得最有料的十几条分成三堆。原帖是英文,以下按意思转述。
第一堆:模型变强,你被吃掉
要人点很多次的老软件。 Greg 觉得相当一部分老软件撑不到 agent 时代,尤其是那种得让人点过很多界面才能把活干完的。道理不复杂:活交给 agent 去干,那些界面本身就成了多余的东西。今年 2 月我写过《死神来了:当 Anthropic 把公司每个部门都「安排」了一遍》,记录的就是这件事在股市上的第一轮反应:Anthropic 每往 Cowork 的插件目录里加一个部门,对应行业的软件股就跌一次。
能被轻易复制的软件。 Greg 说这次看到的逆向和克隆比以往任何时候都多:有人把软件反编译,再用 agent 重做一遍。有人给他看了一套大约 10 个应用,原版每个估值都在 50 亿美元以上,这个人全部克隆成了开源版本。Greg 自己也还没想清楚,软件变得这么容易复制,到底意味着什么。
收入来得快、走得也快的 AI 公司。 现在旧金山讨论的门槛,是 12 个月做到 10 亿美元收入,Greg 说这大概就是新的独角兽标准。但他很少听人谈留存。这一点有数据:Kyle Poyar 和 ChartMogul 在 2025 年底发布的留存报告里,AI 原生产品的毛收入留存中位数只有 40%,净收入留存 48%,月费低于 50 美元的产品,毛留存只有 23%。
套进饭桌问题就很好理解。收入来得快,是因为模型刚好跨过了某条线,大家都想试;走得也快,是因为下一个模型、下一个产品同样能跨过这条线,用户没有留下来的理由。
按小时收费的人。 AI 让人干活至少快了 5 倍,可对按小时收费的自由职业者和代理商来说,这意味着同样一份活,收入少了 5 倍,时薪却还是原来那个数。Greg 觉得这批人很快就得重新想怎么定价。模型越强,他们卖的那一个小时越不值钱。
第二堆:模型变强,你跟着变强
先看一张地图。 Greg 说我们正在经历一次”重新发明计算机”:模型是 CPU,harness 是操作系统,skills 和插件是 App。harness 指包在模型外面那一层,负责给它工具、记忆和权限,决定它能碰什么、怎么干活,Claude Code、Codex 这类编程工具就是典型的 harness。这条在评论区被叫作”非常非常好的 take”,很多创业者拿它找空白。
这张图正好回答了饭桌问题:CPU 升级,操作系统和 App 都跟着变快,前提是你没把自己做成 CPU 的一部分。
把模型当成可替换的零件。 Greg 说他聊过的最好的团队,都把模型当作可以随时换掉的部件。有个创始人给他演示了怎么把不同的活派给不同的模型:品味和视觉交给一个,日常杂活交给便宜的那个,文字交给另一个。他们宁可用能在模型之间搬来搬去的提示词,也不做微调;评估输出好不好,就做 A/B 测试,看用户拿到结果后怎么处理:改没改,导没导出,分没分享。
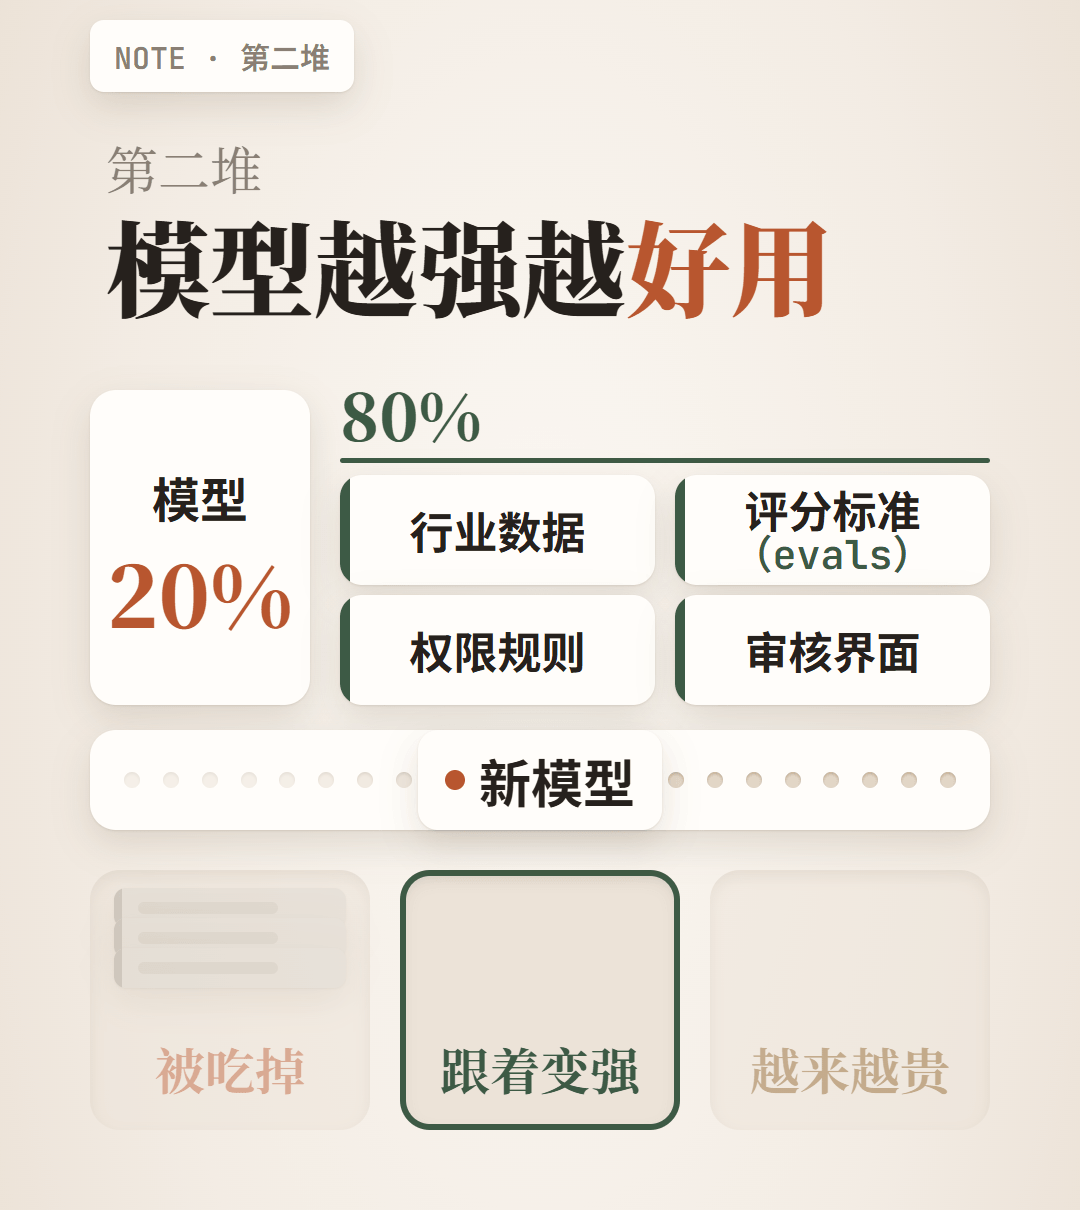
在他看来,一个垂直行业的 harness 基本由四样东西组成:接入这个行业数据的连接器、由懂这行的人写的 evals(用来给 AI 的输出打分的测试题和评分标准)、规定 agent 能碰什么不能碰什么的规则,以及一个干净的、让人来审核的界面。模型可能只占 20%。剩下那 80% 不会因为新模型发布而贬值,新模型一来,反而像给它换了一台更强的发动机。
给 agent 造积木。 很多创始人在做 agent 用的基础部件:API、数据层、工具。Greg 见到的一些公司几乎没有界面,因为它们的主要用户就是 agent。他在补充帖里还有一句:你的产品现在要被卖两次,先得让 agent 选中它,再得让人足够信任这个选择,点头同意。模型越强,agent 干的活越多,这些积木的销量只会跟着涨。
第三堆:跟模型强弱无关,但越来越贵的东西
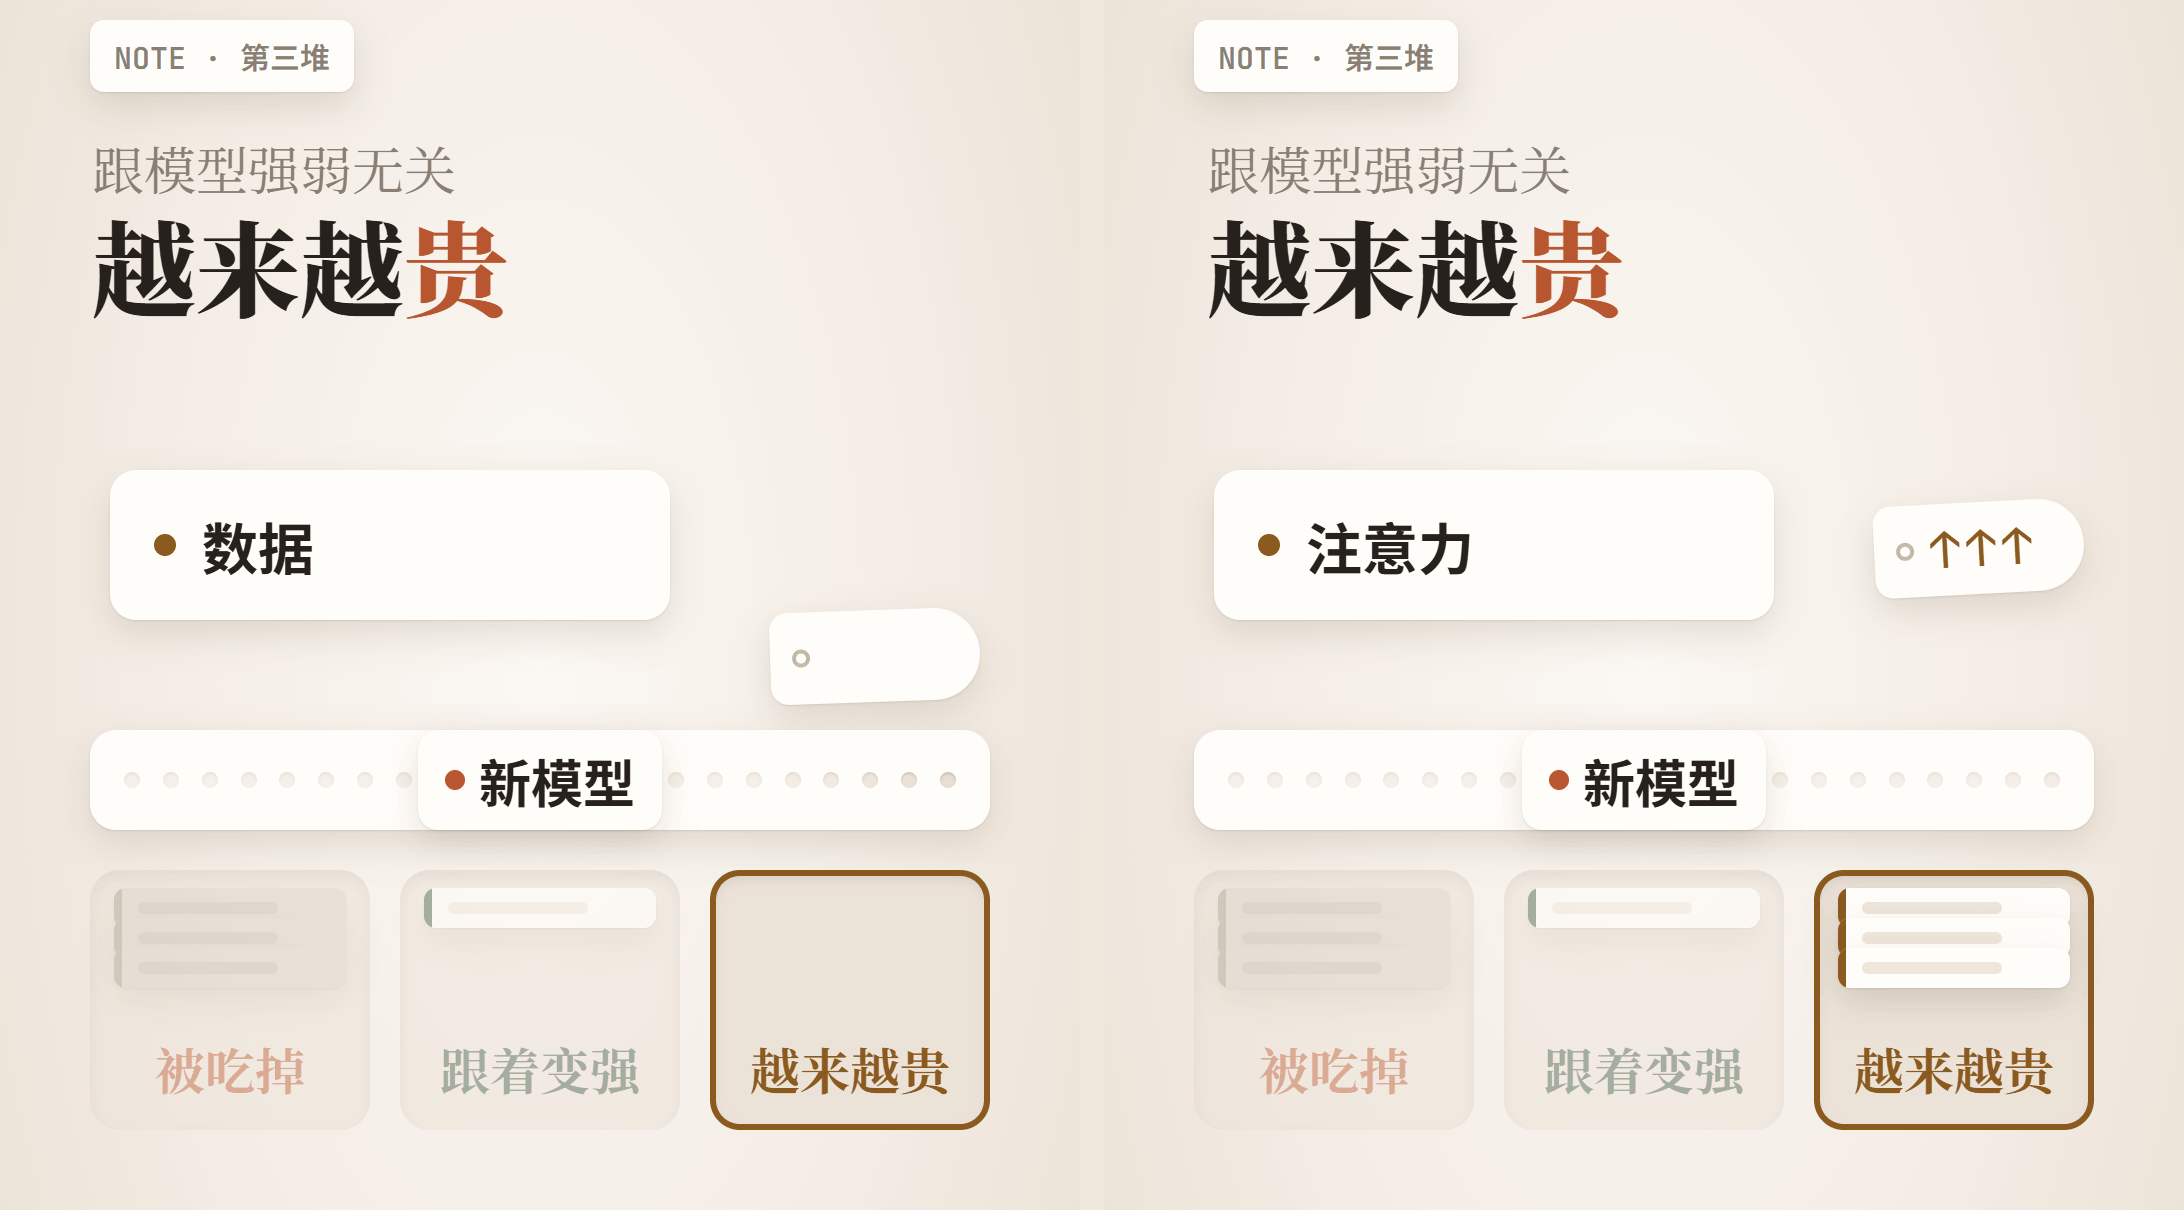
有几条观察装不进上面两堆。它们跟模型强弱没什么关系,但因为软件越来越便宜,反而越来越贵。
数据。 Greg 听到太多数据中间商的故事:把公司数据卖给大模型实验室,一周能赚 200 万美元左右。他也拿不准这是开端还是泡沫。AI Lately 的一篇文章把他这 21 条逐条打分,在这一条上找到的证据是:美国数据经纪公司 Protege 的交易额从 2025 年的 3000 万美元涨到 2026 年的至少 1 亿美元,折合每周约 190 万美元。
顺着这条,Greg 的猜测是价值会往数据那边走。软件能被很快重做,一家老 SaaS 公司真正值钱的,是里面攒了多年的客户数据和工作流,”有些 SaaS 公司其实是数据公司”。以前收购这类公司按年度经常性收入的 2 倍出价,以后也许得换一套估值方法。更极端的是:一家倒闭的创业公司,留下 5 年的 Slack、邮件和代码,可以打包授权换钱,也就是说有些公司死了比活着值钱… 还有一样东西实验室很难拿到:agent 在真实公司里犯错的记录。谁手里有这些日志,谁就有值钱的东西。
但有数据和数据能用是两回事。Greg 聊过的每家公司都想把内部数据汇到一处,再通过 MCP(让 AI 连接外部工具和数据的通用接口)交给 agent 用。然后他们一看数据就傻了:同一个客户有五个版本,一堆早就没人说话的 Slack 频道,还有一堆搜不了的 PDF。这条底下很多人回复”这就是我们在做的”。
记忆。 一位大型消费公司的负责人跟 Greg 说,下一场仗打的是记忆:谁记得你最多,谁就赢,最聪明的模型没有大家想的那么重要。我做健康穿戴,对这句话感受很深。8 月我在《AI 已经把”一人一药”做成了,接下来轮到你的健康数据了》里写过:AI 无法分析未曾记录过的过去。模型可以每个月换一个更聪明的,你过去两年每一晚的睡眠和心率,换不来。
品味,和会写 evals 的人。 好几个人告诉 Greg,他们最想招的是”有品味、会写 evals 的人”。模型越来越擅长出主意,难的变成判断哪个主意好。评论区有人把品味拆得更细:判断什么有效,再加上快速验证的能力。生成越便宜,判断就越贵。
注意力。 最后一条是 Greg 原帖的压轴:现在想拿到大规模的分发非常难。创始人在赞助公交车、疯狂买广告牌、请知名 DJ 办派对,只为了被看见,有点互联网泡沫时代的味道。他说注意力才是稀缺的东西,甚至觉得全球也许只有 50 个人知道怎么在这个时代高效地把这类生意做大。
把这个问题问你自己
这把筛子不只适用于公司。补充帖里有一条是给大学毕业生的:以前的建议是”追随你的热情”,现在变成了”选那些不靠文档驱动、规则不那么死、结果不那么容易验证的职业”。
这其实就是个人版的饭桌问题。结果容易验证的工作,恰恰是模型最容易练会的,因为对错可以自动打分。模型每变强一次,这类工作就被吃掉一点;反过来,需要判断、需要和人打交道、需要承担后果的工作,会因为模型变强而多出一个得力助手。
另一条是:人均营收成了新的炫耀方式。创始人以前炫耀团队有多少人,现在炫耀用多少人干了多少事。
当然,这 40 条要打个折听。Greg 自己也写了:美国只有 2% 的人在为 AI 产品付费,可在旧金山,感觉是 110%。他引用 Chris Dixon 的话:”最聪明的人周末在做的事,10 年后所有人工作日都会做。”他觉得这个时间差已经从 10 年缩到了 12 个月。旧金山的时钟比别处快,”12 个月”未必准,但方向大概率是对的。
所以,下次看到新模型发布的消息,不妨先问自己一句:今天这条新闻,对我来说是好消息,还是坏消息?
原文:Greg Isenberg 在 X 上的长帖。逐条评分:AI Lately(Ryan Elliott Dennis,2026-10-15)。留存数据:The AI churn wave(Kyle Poyar × ChartMogul,2025-12-10)。